Métodos para definir os pesos dos critérios
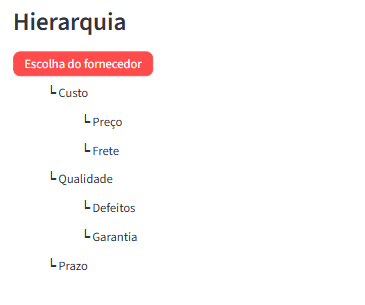
O peso diz o quanto cada critério importa para o objetivo. No Software Decisão, os critérios que têm o mesmo pai na árvore formam um grupo e recebem os pesos juntos. O peso global de cada critério final é o produto dos pesos ao longo do caminho na árvore, e os pesos globais somam 1. Com vários decisores, o software calcula a média, o desvio padrão e a mediana do peso de cada critério e aponta onde as opiniões divergem.
Direct Rating (avaliação direta)
No Direct Rating, cada decisor dá uma nota de 0 a 10 à importância de cada critério, sem comparar os critérios dois a dois. Em cada grupo, a nota de cada critério é dividida pela soma das notas do grupo: notas 8 e 2, por exemplo, geram os pesos 0,8 e 0,2. Notas iguais são permitidas, e a nota 0 indica um critério que não contribui para o objetivo.
Quando usar: quando é preciso rapidez e uma conta fácil de explicar a qualquer pessoa. Cuidado: como não há comparação par a par, não existe teste de consistência; vale começar pelos critérios mais e menos importantes.
Referência: Zardari, N. H.; Ahmed, K.; Shirazi, S. M.; Yusop, Z. B. Weighting Methods and their Effects on Multi-Criteria Decision Making Model Outcomes in Water Resources Management. SpringerBriefs in Water Science and Technology. Springer, 2015.
Rank Sum (soma de postos)
No Rank Sum, cada decisor apenas ordena os critérios de cada grupo por importância: 1 para o mais importante, 2 para o segundo, e assim por diante. Cada posto é invertido, para que o mais importante fique com o maior valor, e dividido pela soma dos invertidos. Com quatro critérios, os postos 1, 2, 3 e 4 viram os pesos 0,4; 0,3; 0,2 e 0,1. Critérios igualmente importantes podem dividir o mesmo posto.
Quando usar: quando o decisor sabe ordenar os critérios, mas prefere não dar notas. Cuidado: a distância entre dois postos seguidos é sempre a mesma; se um critério for muito mais importante que os outros, o Rank Sum não mostra essa diferença.
Referência: Zardari et al. (2015), a mesma do Direct Rating.
AHP (Analytic Hierarchy Process)
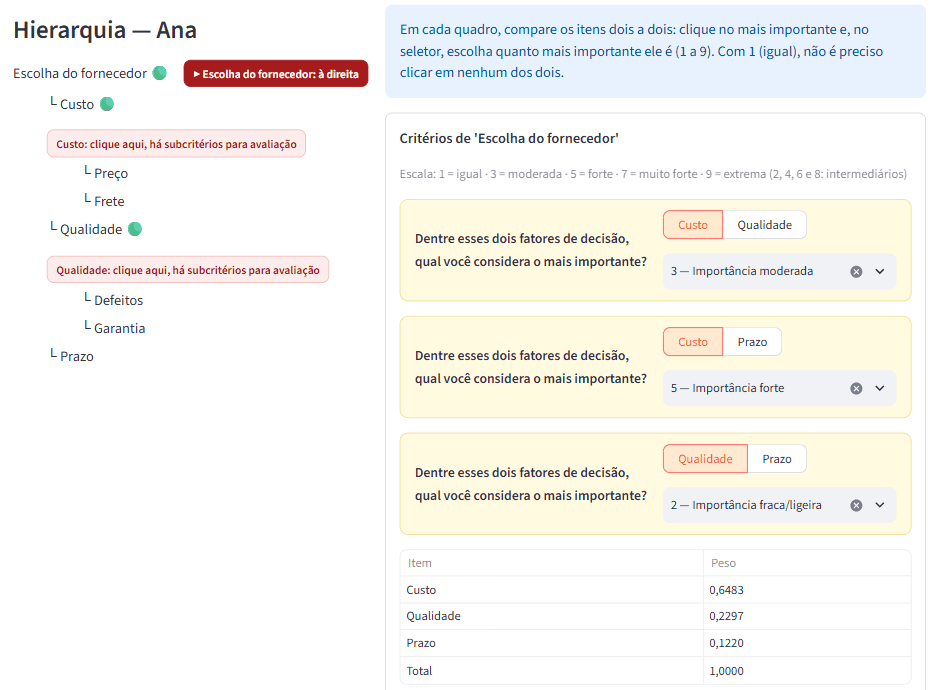
No AHP, criado por Thomas Saaty, cada decisor compara os critérios dois a dois e diz quanto um é mais importante que o outro, na escala de 1 a 9. As respostas formam uma matriz de comparação, e o software calcula os pesos pelo autovetor principal, o método original de Saaty. O AHP também mede a coerência das respostas: se A vale o dobro de B e B vale o dobro de C, o coerente é A valer quatro vezes C. Uma razão de consistência (RC) até 0,10 indica respostas aceitáveis; acima disso, o software aponta os pares que vale revisar, sem bloquear o cálculo.
Quando usar: quando se quer comparar com calma e conferir a coerência dos julgamentos. Cuidado: o número de pares cresce rápido; com mais de cinco itens num grupo, as respostas tendem a ficar menos consistentes.
Referência: Saaty, T. L. The Analytic Hierarchy Process. New York: McGraw-Hill, 1980.
BWM (Best-Worst Method)
O BWM, proposto por Jafar Rezaei em 2015, pede bem menos comparações que o AHP. Em cada grupo, o decisor escolhe o melhor critério (o mais importante) e o pior (o menos importante), diz quanto o melhor é preferido a cada um dos outros e quanto cada um dos outros é preferido ao pior, na mesma escala de 1 a 9. Um grupo com cinco critérios pede sete comparações (no AHP seriam dez). O software calcula os pesos pelo modelo linear de Rezaei (2016) e mede a coerência pela razão de consistência de Liang, Brunelli e Rezaei (2020), indicando o critério a revisar, sem bloquear o cálculo.
Quando usar: quando há muitos critérios e pouco tempo para comparações. Cuidado: recomenda-se até nove itens por grupo; com mais, vale dividir os critérios em subgrupos.
Referências: Rezaei, J. Best-worst multi-criteria decision-making method. Omega, v. 53, p. 49-57, 2015. Rezaei, J. Best-worst multi-criteria decision-making method: some properties and a linear model. Omega, v. 64, p. 126-130, 2016. Liang, F.; Brunelli, M.; Rezaei, J. Consistency issues in the best worst method: measurements and thresholds. Omega, v. 96, 102175, 2020.